「サービスにすでに API があるのに、なぜ MCP を使うのか」は、当社のディレクトリを初めて見る開発者から最もよく寄せられる質問です。もっともな疑問ですが、答えは意外とシンプルです。API の代わりに MCP を使うのではありません。API の上に、特定の種類の呼び出し元のために使うのです。
その呼び出し元とは AI モデルです。通常のプログラムには不要なものをモデルが何を必要とするかが見えてくると、MCP と API の違いは曖昧ではなくなります。このガイドでは、具体的な例、並べて比較した表、そして MCP を完全に避けるべきケースを通して、その違いを解説します。
要点
- MCP は API を置き換えるものではありません。ほとんどの MCP server は、すでに存在する API の薄いレイヤーです。
- 違いは呼び出し元にあります。API は開発者が書いたコードに応え、MCP は実行時にツールを発見するモデルに応えます。
- Function calling はモデル側の半分であり、MCP はツールの記述・発見・到達の方法をアプリ間で標準化します。
- モデルが判断しない場合は API を直接使い、1 つのアプリの 1 つの機能には function calling を、多くのアプリやエージェントがツールを必要とする場合は MCP を使います。
ひとつの段落で答えると
API は、REST、GraphQL、gRPC のいずれであっても、あるソフトウェアが別のソフトウェアに何かを依頼するための仕組みです。呼び出す側は、どのエンドポイントにアクセスし、何を送信し、どう認証するかをあらかじめ把握していることが前提です。それは開発者がそのコードを書いているからです。MCP は、AI アプリが実行時にツールを検出し、モデルに代わってそれらを呼び出すためのプロトコルです。MCP server は、平易な言葉で書かれた説明と入力スキーマを備えたツールの一覧を公開し、モデルがその中からひとつを選ぶと、サーバーが実際の API 呼び出しを行います。HostedMCP で見つかる MCP server のほとんどはまさにこれで、すでに存在していた API の上に重ねた薄い層です。
具体例: Stripe での返金
AI アシスタントに「この顧客の直近の課金を返金して」という処理を任せたいとします。
API だけを使う場合、アシスタントのための連携コードを誰かが書く必要があります。モデルが理解できる関数スキーマを、名前と説明とともに定義します。API キーを扱います。顧客を検索し、課金を一覧し、最新のものを選び、返金を作成し、Stripe のエラーコードをモデルが対処できる形に変換します。そしてそれを 1 つのアプリの中に組み込みます。サポートチームが同じことを Claude で、開発者が Cursor でやりたいと思ったら、その作業は別の形式で、別のコードベースで、もう一度行われます。
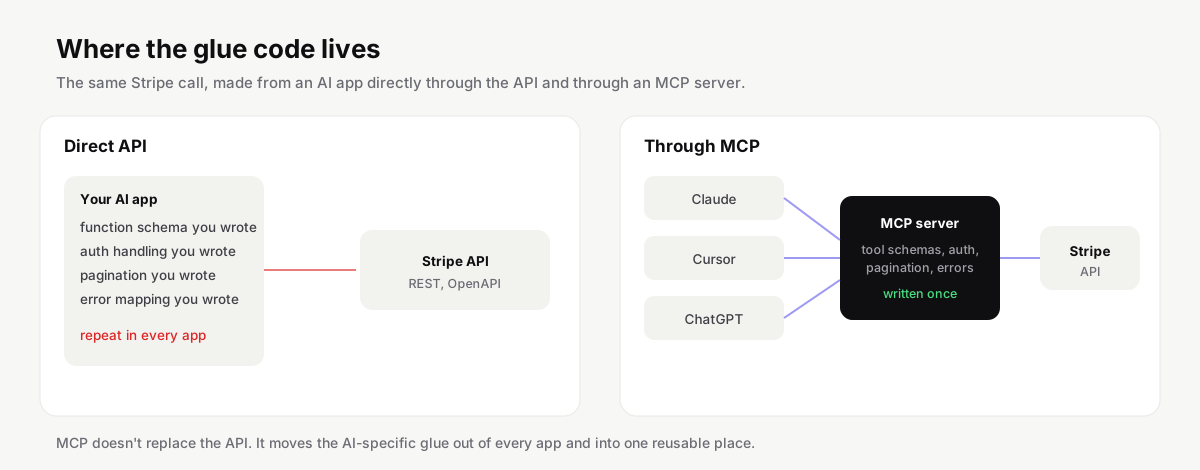
MCP を使うと、そのグルーコードは 1 つの server に移ります。list_charges や create_refund といったツールを、モデル向けに書かれた説明とともに公開します。キーや OAuth トークンを保持します。Claude、Cursor、ChatGPT、VS Code など、どの MCP クライアントでも接続でき、同じ動作が得られます。Stripe の API はまったく変わっていません。変わったのは、AI 固有の部分を誰が書くのか、そしてそれを何回書くのかという点です。
並べて比較
| 従来の API | MCP | |
|---|---|---|
| 呼び出すのは誰か | 開発者が書いたコード | AI モデル(ホストアプリ経由) |
| 呼び出し側は何が存在するかをどう知るか | ビルド時にドキュメントを読む | 実行時にサーバーへ問い合わせる(tools/list) |
| 説明は誰に向けて書かれるか | 開発者 | モデル:ツールが何をし、いつ使うか |
| メッセージ形式 | さまざま:REST、GraphQL、gRPC | すべてのサーバーで JSON-RPC 2.0 |
| 認証 | API キー、OAuth、サービスごとに選択 | ローカルサーバーは環境変数、リモートは OAuth 2.1 |
| 操作の範囲 | API が公開するすべて | サーバーが提供を選んだツールのみ |
| 1 つの統合が動く範囲 | 1 つのアプリ | すべての MCP クライアント |
| 一般的なレイテンシ | ネットワーク 1 ホップ | サーバー経由で 1 ホップ追加 |
このうち 2 行は、通常よりも注目に値します。
本当の違いはディスカバリーです。API を呼び出すプログラムは実行時に「何ができるか」を尋ねることはありません。開発者がすでに知っているからです。一方、モデルはセッションごとに尋ねる必要があり、推論できる言葉で答えを受け取る必要があります。だからこそ MCP のツール説明は、リファレンスドキュメントではなく助言のように書かれます(「特定のパスに触れるオープンなプルリクエストを探すにはこれを使う」)。
スコープは安全機能です。あるサービスの API キーは通常、そのキーに許可されたすべての操作を付与します。MCP サーバーは、どのアクションがそもそも存在するかを決めます。読み取り専用の分析サーバーは、delete ツールを含めないようにするだけで済みます。モデルに「何も削除しないでください」と言うだけでは、同じ保証は得られません。
MCP と function calling
function calling(ベンダーによっては tool use とも呼ばれます)は、モデル API の機能です。リクエストに関数を列挙すると、モデルが「この引数でこの関数を呼び出してください」と応答することがあります。MCP は最終的にこの機能を利用するため、両者はしばしば混同されます。
両者の関係は次のとおりです。ホストアプリ(たとえば Claude Code)は MCP server に接続してツールを収集します。モデルにリクエストを送るとき、それらのツールを関数定義として渡します。モデルが呼び出しを要求すると、ホストはその呼び出しを適切な MCP server にルーティングし、結果をモデルに返します。つまり、function calling はモデルに面した半分であり、MCP はその反対側のすべて、すなわちツールの記述、検出、認可、到達の方法をベンダーをまたいで標準化するものです。
1 つのアプリで 1 つの機能を 1 つのモデル向けに作るなら、素の function calling のほうが手間が少なく、まったく問題ありません。MCP が効果を発揮するのは、同じツールを多くのアプリで動かしたい場合や、ユーザーに自分の AI クライアントを持ち込んでもらいたい場合です。
| function calling | MCP | |
|---|---|---|
| 概要 | 1 つのモデル API の機能 | AI アプリとツールサーバー間のプロトコル |
| ツールの定義場所 | アプリからモデルへのリクエスト内 | 任意のクライアントが接続できる独立したサーバー内 |
| 動作する範囲 | 自分が書いたアプリ | すべての MCP クライアント |
| 検出 | リクエストごとにリストを渡す | クライアントが実行時にサーバーへ問い合わせる |
| 適する用途 | 1 つの機能、1 つのアプリ、1 つのモデル | アプリ、エージェント、ベンダーをまたいで共有するツール |
API が適切な選択となるケース
モデルが関与しない場合は MCP を使いません。Web フロントエンド、モバイルアプリ、夜間の同期ジョブ、パートナー連携は、API を直接呼び出すべきです。そこに MCP レイヤーを追加しても得られるものはなく、ホップが増えるだけです。
すべての呼び出しを正確に制御する必要がある場合も使いません。決済のキャプチャ、一括削除、テストと監査証跡を備えた人間が書いたコードパスを望むものは、たとえ AI がそのコードの作成を支援したとしても、API を呼び出す通常のコードに属します。
また、モデルがすでに手元にあるデータだけを必要とする場合も使いません。アプリが顧客レコードを取得してプロンプトに貼り付けるなら、それはツールではなくコンテキストであり、サーバーは必要ありません。
| 状況 | 使用するもの |
|---|---|
| Web またはモバイルのフロントエンドがバックエンドを呼び出す | API |
| 夜間の同期やパートナー連携 | API |
| 決済、一括削除、監査証跡が必要なもの | テスト済みのコードから API を呼び出す |
| アプリがすでにデータを持ち、それをプロンプトに貼り付ける | どちらでもない。それはコンテキストであり、ツールではない |
| 自分が管理する 1 つのアプリ内の 1 つの AI 機能 | Function calling |
| モデルが何を調べるか、何をするかを決めるべき | MCP |
| 顧客が Claude、Cursor、ChatGPT を使う | MCP、理想的にはホスト型サーバー |
| 複数の内部エージェントが同じシステムを必要とする | 共有の MCP サーバー 1 つ |
MCP が適切な選択となる場合
モデルに何をするかを判断させたいときは MCP を選んでください。情報を調べたり、チケットを起票したり、データベースにクエリを投げたり、デプロイを確認したりするエージェントにはツールが必要であり、MCP はそうしたツールを渡すための標準的な方法です。
自社プロダクトを他の人の AI ツールでも動かしたい場合にも適しています。顧客が Claude、Cursor、ChatGPT を使っているなら、1 つの MCP server でそのすべてに届きます。GitHub、Linear、Notion、Stripe といった企業が自社のサーバーを公開しているのはそのためです。HostedMCP では、公式サーバーを製品別に閲覧でき、ホスト型かローカル実行かを確認できます。
社内で複数のエージェントを運用している場合にも役立ちます。システムごとに 1 つの MCP server を用意してすべてのエージェントで共有する方が、ツールのコードを各エージェントにコピーするよりも、セキュリティ確保と更新がはるかに容易です。

セキュリティの考え方も異なります
API と MCP server では直面する脅威が異なります。主な理由は、モデルが処理のループに入るからです。
API の場合、呼び出し元は自分のコードであり、書いたとおりに動作します。MCP の場合、呼び出し元は信頼できないテキストを読むモデルです。そのテキストには Web ページ、メール、issue のコメントなどがあります。注意深く書かれた issue のコメントは、モデルに呼び出すべきでないツールを呼び出させようとする可能性があります。これがプロンプトインジェクションであり、優れたホストがデータを変更するツールを実行する前に確認を求める理由であり、サーバーが有用な最小限のツールだけを公開すべき理由でもあります。
MCP 仕様はトークンについても厳格な方針を示しています。セキュリティのベストプラクティスでは、サーバーはそのサーバーに発行されていないトークンを受け入れてはならず、ユーザーのトークンを別のサービスに渡してはならないとされています。このアンチパターンにはトークンパススルーという名前があり、サーバーを信頼する前にコードで確認する価値のある項目の一つです。リモートサーバーの場合、認可は OAuth 2.1 に従い、2026-07-28 の改訂ではクライアント登録が Client ID Metadata Documents に移行します。詳細は MCP セキュリティガイド をご覧ください。
注意
MCP ツールが受け取るすべての引数を信頼できない入力として扱ってください。その引数を選んだモデルは、誘導を目的として書かれた Web ページや issue のコメントを読んでいる可能性があります。
パフォーマンスとコスト
MCP は遅いと心配する声をときどき聞きます。ローカルサーバーは同じマシン上のプロセスへの呼び出しを 1 回追加し、リモートサーバーは HTTP のラウンドトリップを 1 回追加します。どちらも、モデルが回答を書き上げるまでにかかる数秒に比べればわずかなものです。
実際に重要なコストはコンテキストです。ホストが読み込むツールにはそれぞれ説明とスキーマが付いており、モデルはそれを読む必要があります。さらに、ツールの実行結果はすべて会話に残ります。冗長なツールを 80 個そろえたサーバーは、何も質問していない段階でコンテキストウィンドウを目に見えて消費することがあります。HostedMCP のすべてのサーバーページでツールの一覧をすべて表示しているのは、そのためです。インストールする前にサーバーの規模がわかり、目的を絞ったサーバーで事足りるなら、より小さいものを選べます。
API を優れた MCP server にする
魅力的な近道は、OpenAPI ファイルからエンドポイントごとに 1 つのツールを生成することです。まさにそれを行うツールは存在し、素早いプロトタイプには役立ちます。しかし、それらが優れたサーバーになることはほとんどありません。数百のほぼ同一のツールを含むリスティングをいくつか開けば、問題はすぐにわかります。モデルはそれらすべてを読まなければならず、そのほとんどは会話の中で誰も尋ねないエンドポイントに対応しているからです。
モデルはエンドポイント単位では考えません。タスク単位で考えます。「請求書 1042 についてメールを送ってきた顧客を見つけて、直近 3 件の請求を表示して」は、複数のエンドポイントにまたがる 1 つのタスクです。優れたサーバーは、そのレベルでツールを提供します。メールアドレス、請求書番号、または名前を受け取る find_customer と、40 個のフィールドを持つ生の JSON ではなく、短く読みやすいサマリーを返す recent_charges です。
| エンドポイント型のツール | タスク型のツール |
|---|---|
GET /customers?email= |
メールアドレス、請求書番号、または名前を受け取る find_customer |
40 個のフィールドを返す GET /charges?customer= |
短く読みやすいサマリーを返す recent_charges |
| エンドポイントごとに 1 つのツール、合計で数百 | 人が尋ねる内容に合わせた少数のツール |
| リファレンスドキュメントからコピーした説明 | ツールをいつ使うべきかを示す説明 |
いくつかの習慣が大きな違いを生みます。
-
モデルのために説明を書く。 何を返すかだけでなく、そのツールが何のためで、いつ使うべきかを示します。「返金を作成する前に、この請求がその顧客のものかを確認するために使う」は、フィールドの一覧よりもモデルにとって価値があります。
-
返す情報を減らす。 レスポンスは、人が実際に目にするフィールドだけに絞り、明確なカーソルでページネーションします。余分なフィールドはコンテキストを消費し、モデルが誤読する余地を増やします。
-
危険なツールを明確にする。
delete_projectのようにわかりやすく命名し、仕様が提供する read-only と destructive のヒントを使って、ホストが確認を求められるようにします。さらに良いのは、破壊的な操作を最初のバージョンには含めないことです。 -
すべてを検証する。 引数は、信頼できないテキストを読んだモデルから渡されます。型、範囲、所有権をサーバー側で検証します。公開エンドポイントに対して行うのと同じように。
では、どちらを構築すべきでしょうか
まだ API がない場合は、まず API を構築してください。自社アプリ、スクリプト、パートナーはどのみち API を必要としますし、堅牢な API の土台がない MCP server は、より劣った第二の API になりがちです。
すでに API があり、AI ツールから自社プロダクトを使えるようにしたい場合は、その前に MCP server を追加してください。ユーザーが実際に求める操作に合わせた少数のツールから始め、説明文は開発者向けではなくモデル向けに書き、可能であればローカルパッケージとホスト型エンドポイントの両方として提供してください。MCP server の構築ガイドでは、現行の SDK を使った TypeScript と Python での手順を解説しています。
自分で管理する単一のアプリ内で AI 機能が 1 つだけ必要な場合は、現時点では function calling で十分です。後からその関数を MCP server に昇格させても、土台の API を変更する必要はありません。
次に進むべき方向
実際にどのようなものか確認するには、よく知られた API をラップしたサーバーをいくつか開いてみてください。たとえば GitHub server や Postgres servers などです。そして、それらのツール一覧を元の API ドキュメントと比較してみてください。意図的にかなり多くの情報を省いていることが分かります。プロトコルが初めての方は what MCP is から始めてください。まずは1つ試してみたいという方は、client guides にエディタごとの正確な設定が載っています。