« Pourquoi utiliser MCP alors que le service dispose déjà d'une API ? » est la question qui nous revient le plus souvent de la part des développeurs qui consultent notre annuaire pour la première fois. La question est légitime, et la réponse tient finalement en peu de mots : vous n'utiliseriez pas MCP à la place de l'API. Vous l'utiliseriez par-dessus l'API, pour un type d'appelant bien précis.
Cet appelant, c'est un modèle d'IA. Dès que l'on voit ce dont un modèle a besoin et qu'un programme classique n'a pas, la différence entre MCP et une API cesse d'être floue. Ce guide la détaille avec un exemple concret, un tableau comparatif et les cas où il vaut mieux laisser MCP de côté.
Points clés
- MCP ne remplace pas une API. La plupart des MCP servers sont une fine couche au-dessus d'une API qui existe déjà.
- La différence tient à l'appelant : une API sert du code écrit par un développeur, MCP sert un modèle qui découvre des outils à l'exécution.
- Le function calling est la moitié tournée vers le modèle ; MCP standardise la façon dont les outils sont décrits, trouvés et atteints d'une application à l'autre.
- Utilisez l'API directement quand aucun modèle ne décide, le function calling pour une fonctionnalité dans une application, MCP quand de nombreuses applications ou agents ont besoin de l'outil.
La réponse en un paragraphe
Une API, qu'elle soit REST, GraphQL ou gRPC, est le moyen par lequel un logiciel demande à un autre d'accomplir une action. Elle suppose que l'appelant sait déjà quel endpoint appeler, quoi envoyer et comment s'authentifier, car un développeur a écrit ce code. MCP est un protocole qui permet aux applications d'IA de découvrir des outils à l'exécution et de les appeler pour le compte d'un modèle. Un MCP server publie une liste d'outils accompagnés de descriptions en langage naturel et de schémas d'entrée ; le modèle en choisit un, et le serveur effectue les appels API proprement dits. La plupart des MCP servers que vous trouverez sur HostedMCP sont exactement cela : une fine couche au-dessus d'une API qui existait déjà.
Un exemple concret : les remboursements dans Stripe
Imaginons que vous vouliez qu'un assistant IA gère « rembourser la dernière charge de ce client ».
Avec l'API seule, quelqu'un doit écrire cette intégration pour l'assistant. Il définit un schéma de fonction que le modèle comprend, avec des noms et des descriptions. Il gère la clé d'API. Il recherche le client, liste les charges, sélectionne la plus récente, crée le remboursement et transforme les codes d'erreur de Stripe en quelque chose sur quoi le modèle peut agir. Puis il livre le tout dans une seule application. Quand l'équipe support veut la même chose dans Claude et que les développeurs la veulent dans Cursor, ce travail est refait, dans un autre format, dans une autre base de code.
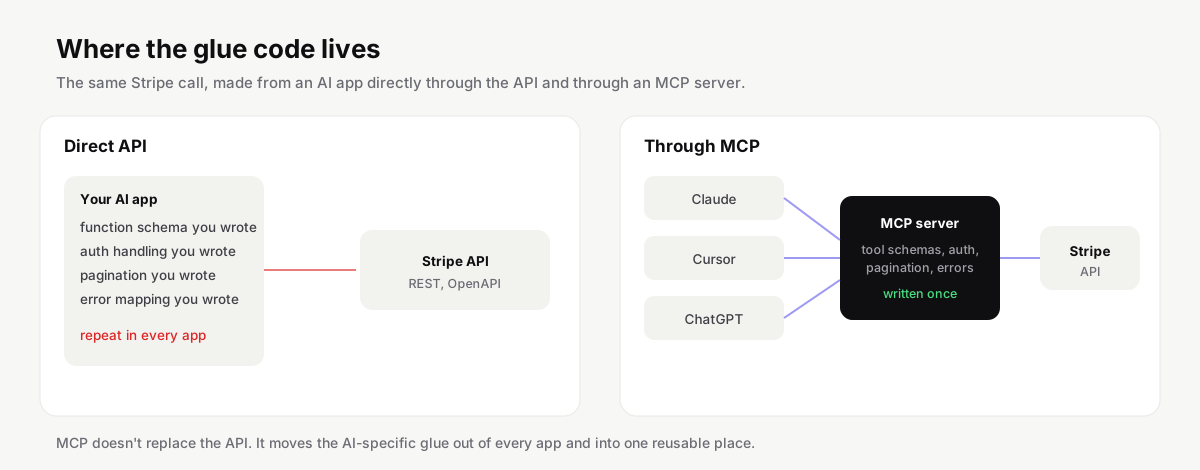
Avec MCP, ce code de liaison est regroupé dans un seul serveur. Il expose des outils comme list_charges et create_refund, avec des descriptions rédigées pour un modèle. Il détient la clé ou le token OAuth. N'importe quel client MCP, Claude, Cursor, ChatGPT, VS Code, peut s'y connecter et obtenir le même comportement. L'API de Stripe n'a pas changé du tout. Ce qui change, c'est qui doit écrire les parties spécifiques à l'IA, et combien de fois.
Côte à côte
| API classique | MCP | |
|---|---|---|
| Qui l'appelle | Du code écrit par un développeur | Un modèle d'IA, via une application hôte |
| Comment l'appelant découvre ce qui existe | En lisant la doc au moment du build | En interrogeant le serveur à l'exécution (tools/list) |
| Les descriptions sont écrites pour | Les développeurs | Les modèles : ce que fait l'outil et quand l'utiliser |
| Format des messages | Variable : REST, GraphQL, gRPC | JSON-RPC 2.0 pour tous les serveurs |
| Authentification | Clés d'API, OAuth, selon le choix du service | Variables d'environnement pour les serveurs locaux, OAuth 2.1 pour les serveurs distants |
| Périmètre des actions | Tout ce que l'API expose | Uniquement les outils que le serveur choisit d'exposer |
| Une intégration fonctionne dans | Une seule application | Tous les clients MCP |
| Latence typique | Un aller-retour réseau | Un aller-retour supplémentaire via le serveur |
Deux lignes méritent plus d'attention qu'on ne leur en accorde d'habitude.
La découverte est la vraie différence. Un programme qui appelle une API ne demande jamais « que sais-tu faire ? » à l'exécution ; le développeur le savait déjà. Un modèle, lui, doit poser la question à chaque session, et il a besoin d'une réponse formulée dans des mots sur lesquels il peut raisonner. C'est pourquoi la description d'un outil MCP se lit comme un conseil (« Utilisez ceci pour trouver les pull requests ouvertes qui touchent un chemin donné ») plutôt que comme une documentation de référence.
Le périmètre est une garantie de sécurité. Une clé d'API pour un service accorde généralement tout ce que cette clé est autorisée à faire. Un serveur MCP décide, lui, quelles actions existent tout court. Un serveur d'analytique en lecture seule peut simplement ne pas inclure d'outil delete. On n'obtient pas la même garantie en disant à un modèle « ne supprime rien, s'il te plaît ».
MCP vs function calling
Le function calling, ou tool use comme certains fournisseurs l'appellent, est une fonctionnalité d'une API de modèle : vous listez des fonctions dans votre requête, et le modèle peut répondre par « appelle cette fonction avec ces arguments ». On le confond souvent avec MCP parce que MCP finit par l'utiliser.
Voici comment les deux s'articulent. Votre application hôte, par exemple Claude Code, se connecte à des MCP servers et récupère leurs outils. Lorsqu'elle envoie une requête au modèle, elle transmet ces outils comme définitions de fonctions. Quand le modèle demande à en appeler une, l'hôte route cet appel vers le bon MCP server et renvoie le résultat. Le function calling est donc la moitié côté modèle, et MCP est le standard pour tout ce qui se trouve de l'autre côté : la façon dont les outils sont décrits, découverts, autorisés et atteints, quel que soit le fournisseur.
Si vous développez une seule fonctionnalité, dans une seule application, avec un seul modèle, le function calling simple demande moins de travail et convient parfaitement. MCP devient intéressant quand le même outil doit fonctionner dans de nombreuses applications, ou quand vous voulez que les utilisateurs apportent leur propre client IA.
| Function calling | MCP | |
|---|---|---|
| Ce que c'est | Une fonctionnalité d'une API de modèle | Un protocole entre les applications IA et les serveurs d'outils |
| Où les outils sont définis | Dans la requête de votre application au modèle | Dans un serveur séparé auquel tout client peut se connecter |
| Fonctionne dans | L'application que vous avez écrite | Tous les clients MCP |
| Découverte | Vous transmettez la liste à chaque requête | Le client interroge le serveur à l'exécution |
| Idéal pour | Une fonctionnalité, une application, un modèle | Des outils partagés entre applications, agents et fournisseurs |
Quand une API est le bon choix
Écartez MCP lorsqu'aucun modèle n'entre en jeu. Un frontend web, une application mobile, une tâche de synchronisation nocturne ou une intégration partenaire doivent dialoguer directement avec votre API. Ajouter une couche MCP dans ce cas n'apporte rien et ajoute un saut.
Écartez-le aussi lorsque vous avez besoin d'un contrôle précis sur chaque appel. Les captures de paiement, les suppressions en masse, tout ce pour quoi vous voulez un chemin de code écrit à la main, avec des tests et une piste d'audit, relève du code classique qui appelle l'API, même si une IA vous a aidé à écrire ce code.
Et écartez-le lorsque le modèle n'a besoin que de données que vous avez déjà sous la main. Si votre application récupère une fiche client et la colle dans le prompt, ce n'est pas un outil, c'est du contexte, et cela ne nécessite pas de serveur.
| Situation | À utiliser |
|---|---|
| Un frontend web ou mobile appelle votre backend | L'API |
| Une synchronisation nocturne ou une intégration partenaire | L'API |
| Paiements, suppressions en masse ou tout ce qui exige une piste d'audit | L'API, depuis du code testé |
| Votre application dispose déjà des données et les colle dans le prompt | Ni l'un ni l'autre ; c'est du contexte, pas un outil |
| Une fonctionnalité IA au sein d'une application que vous contrôlez | Function calling |
| Un modèle doit décider quoi rechercher ou quoi faire | MCP |
| Vos clients utilisent Claude, Cursor et ChatGPT | MCP, idéalement un serveur hébergé |
| Plusieurs agents internes ont besoin du même système | Un seul serveur MCP partagé |
Quand MCP est le bon choix
Optez pour MCP lorsqu'un modèle doit décider quoi faire. Les agents qui consultent des informations, ouvrent des tickets, interrogent des bases de données ou vérifient un déploiement ont besoin d'outils, et MCP est la façon standard de leur en fournir.
C'est aussi le bon choix lorsque vous voulez que votre produit fonctionne dans les outils d'IA d'autres personnes. Si vos clients utilisent Claude, Cursor et ChatGPT, un seul MCP server les couvre tous. C'est pourquoi des entreprises comme GitHub, Linear, Notion et Stripe publient le leur. Sur HostedMCP, vous pouvez parcourir les serveurs officiels par produit et voir lesquels sont hébergés plutôt qu'exécutés localement.
Et cela aide lorsque vous exécutez plusieurs agents en interne. Un MCP server par système, partagé par tous les agents, est bien plus facile à sécuriser et à mettre à jour que du code d'outils copié dans chaque agent.

La sécurité aussi est différente
Les API et les MCP servers font face à des menaces différentes, principalement parce qu'un modèle intervient dans la boucle.
Avec une API, l'appelant est votre code, et il fait ce que vous avez écrit. Avec MCP, l'appelant est un modèle qui lit du texte non fiable : pages web, e-mails, commentaires d'issues. Un commentaire d'issue soigneusement rédigé peut tenter de convaincre le modèle d'appeler un outil qu'il ne devrait pas. C'est de l'injection de prompt, et c'est pourquoi les bons hôtes demandent confirmation avant d'exécuter des outils qui modifient des données, et pourquoi les serveurs devraient exposer le plus petit ensemble d'outils utile.
La spécification MCP est également ferme sur les jetons. Selon ses bonnes pratiques de sécurité, un serveur ne doit pas accepter de jetons qui ne lui ont pas été délivrés, et ne doit pas transmettre le jeton d'un utilisateur à un autre service. Cet anti-pattern porte un nom, le token passthrough, et c'est l'une des premières choses à vérifier dans le code d'un serveur avant de lui faire confiance. Pour les serveurs distants, l'autorisation suit OAuth 2.1, et la révision 2026-07-28 fait passer l'enregistrement des clients aux Client ID Metadata Documents. Pour en savoir plus, consultez notre guide de sécurité MCP.
Attention
Considérez chaque argument reçu par un outil MCP comme une entrée non fiable. Le modèle qui l'a choisi a peut-être lu une page web ou un commentaire d'issue rédigé pour l'orienter.
Performances et coût
On entend parfois dire que MCP est lent. Un serveur local ajoute un appel à un processus sur la même machine, et un serveur distant ajoute un aller-retour HTTP. Les deux sont négligeables à côté des secondes qu'un modèle passe à rédiger sa réponse.
Le coût qui compte vraiment, c'est le contexte. Chaque outil chargé par l'hôte s'accompagne d'une description et d'un schéma que le modèle doit lire, et chaque résultat d'outil atterrit dans la conversation. Un serveur avec quatre-vingts outils verbeux peut consommer une part notable de la fenêtre de contexte avant même que vous ayez posé la moindre question. C'est l'une des raisons pour lesquelles nous affichons la liste complète des outils sur chaque page de serveur sur HostedMCP : vous pouvez voir la taille d'un serveur avant de l'installer, et en choisir un plus petit si un serveur ciblé fait l'affaire.
Transformer une API en un bon MCP server
Le raccourci tentant consiste à générer un outil par endpoint à partir d'un fichier OpenAPI. Il existe des outils qui font exactement cela, et ils sont utiles pour un prototype rapide. Ils produisent rarement un bon serveur. Ouvrez quelques listings proposant plusieurs centaines d'outils quasi identiques et vous verrez le problème : le modèle doit tous les lire, et la plupart correspondent à un endpoint que personne ne demanderait en conversation.
Un modèle ne raisonne pas en endpoints. Il raisonne en tâches. « Trouve le client qui a écrit à propos de la facture 1042 et montre-moi ses trois derniers prélèvements » est une tâche qui couvre plusieurs endpoints. Un bon serveur propose des outils à ce niveau : find_customer qui accepte un email, un numéro de facture ou un nom, et recent_charges qui renvoie un résumé court et lisible plutôt que le JSON brut avec quarante champs.
| Outil calqué sur l'endpoint | Outil calqué sur la tâche |
|---|---|
GET /customers?email= |
find_customer qui accepte un email, un numéro de facture ou un nom |
GET /charges?customer= renvoyant 40 champs |
recent_charges renvoyant un résumé court et lisible |
| Un outil par endpoint, des centaines au total | Une poignée d'outils correspondant à ce que les gens demandent |
| Descriptions copiées depuis la documentation de référence | Descriptions qui indiquent quand utiliser l'outil |
Quelques habitudes font une grande différence.
-
Rédigez les descriptions pour le modèle. Indiquez à quoi sert l'outil et quand l'utiliser, pas seulement ce qu'il renvoie. « Utilisez ceci avant de créer un remboursement pour confirmer que le prélèvement appartient bien au client » vaut plus pour un modèle qu'une liste de champs.
-
Renvoyez moins. Limitez les réponses aux champs qu'une personne consulterait réellement, et paginez avec un curseur explicite. Chaque champ supplémentaire coûte du contexte et donne au modèle plus d'occasions de se tromper.
-
Rendez les outils dangereux évidents. Nommez-les clairement, comme
delete_project, et utilisez les indications read-only et destructive prévues par la spec, afin que les hôtes puissent demander une confirmation. Mieux encore, laissez les actions destructives hors de la première version. -
Validez tout. Les arguments proviennent d'un modèle qui a lu du texte non fiable. Vérifiez les types, les plages et la propriété côté serveur, comme vous le feriez pour n'importe quel endpoint public.
Alors, que devez-vous construire ?
Si vous n'avez pas encore d'API, commencez par l'API. Votre propre application, vos scripts et vos partenaires en auront besoin de toute façon, et un MCP server sans API solide en dessous finit souvent par devenir une seconde API, moins bonne que la première.
Si vous disposez déjà d'une API et souhaitez que les outils d'IA utilisent votre produit, ajoutez un MCP server devant celle-ci. Commencez par une poignée d'outils qui correspondent à ce que les gens demandent réellement, rédigez des descriptions destinées à un modèle plutôt qu'à un développeur, et proposez-le à la fois comme paquet local et comme endpoint hébergé si possible. Notre guide sur la création d'un MCP server détaille la démarche en TypeScript et en Python avec les SDK actuels.
Si vous avez seulement besoin d'une fonctionnalité d'IA dans une application que vous contrôlez, le function calling suffit aujourd'hui, et vous pourrez promouvoir ces fonctions en MCP server plus tard sans modifier l'API en dessous.
Pour aller plus loin
Pour voir à quoi cela ressemble en pratique, ouvrez quelques serveurs qui encapsulent des API bien connues, comme le serveur GitHub ou l'un des serveurs Postgres, et comparez leurs listes d'outils avec la documentation des API sous-jacentes. Vous remarquerez tout ce qu'ils omettent, volontairement. Si vous découvrez le protocole, commencez par qu'est-ce que MCP, et si vous voulez simplement en essayer un, nos guides clients indiquent la configuration exacte pour votre éditeur.