"Warum sollte ich MCP nutzen, wenn der Service bereits eine API hat?" ist die Frage, die wir am häufigsten von Entwicklern hören, die unser Verzeichnis zum ersten Mal besuchen. Das ist eine berechtigte Frage, und die Antwort ist kurz: Du würdest MCP nicht anstelle der API nutzen. Du würdest es zusätzlich zur API nutzen, und zwar für eine ganz bestimmte Art von Client.
Dieser Client ist ein KI-Modell. Sobald du verstehst, was ein Modell benötigt, was ein normales Programm aber nicht braucht, wird der Unterschied zwischen MCP und einer API klar. Dieser Guide führt dich anhand eines konkreten Beispiels, einer Vergleichstabelle und der Fälle, in denen du MCP komplett überspringen solltest, durch das Thema.
Wichtigste Erkenntnisse
- MCP ersetzt keine API. Die meisten MCP server sind lediglich ein dünner Layer über einer bereits existierenden API.
- Der Unterschied liegt im Client: Eine API bedient Code, den ein Entwickler geschrieben hat; MCP bedient ein Modell, das Tools zur Laufzeit entdeckt.
- Function calling ist die Komponente, die dem Modell gegenübersteht; MCP standardisiert, wie Tools über verschiedene Apps hinweg beschrieben, gefunden und aufgerufen werden.
- Nutze die API direkt, wenn kein Modell entscheidet; nutze Function calling für ein einzelnes Feature in einer App; nutze MCP, wenn viele Apps oder Agenten das Tool benötigen.
Die Antwort in einem Absatz
Eine API – egal ob REST, GraphQL oder gRPC – ist die Art und Weise, wie eine Software eine andere bittet, etwas zu tun. Sie setzt voraus, dass der Aufrufer bereits weiß, welchen Endpoint er ansteuern muss, was zu senden ist und wie die Authentifizierung funktioniert, weil ein Entwickler diesen Code geschrieben hat. MCP hingegen ist ein Protokoll, mit dem KI-Apps Tools zur Laufzeit entdecken und im Namen eines Modells aufrufen können. Ein MCP server veröffentlicht eine Liste von Tools mit Beschreibungen in natürlicher Sprache und Input-Schemas; das Modell wählt eines aus, und der Server führt die eigentlichen API-Aufrufe aus. Die meisten MCP server, die du auf HostedMCP findest, sind genau das: ein dünner Layer über einer bereits existierenden API.
Ein konkretes Beispiel: Rückerstattungen in Stripe
Angenommen, du möchtest, dass ein KI-Assistent die Anweisung "erstatte die letzte Zahlung für diesen Kunden zurück" ausführt.
Wenn du nur die API nutzt, muss jemand diese Integration für den Assistenten schreiben. Man definiert ein Function Schema, das das Modell versteht, inklusive Namen und Beschreibungen. Man kümmert sich um den API-Key. Man sucht den Kunden, listet die Zahlungen auf, wählt die aktuellste aus, erstellt die Rückerstattung und wandelt die Fehlercodes von Stripe in etwas um, mit dem das Modell arbeiten kann. Dann wird das Ganze in einer App ausgeliefert. Wenn das Support-Team dasselbe in Claude möchte und die Entwickler es in Cursor brauchen, muss diese Arbeit erneut erledigt werden – in einem anderen Format und in einer anderen Codebase.
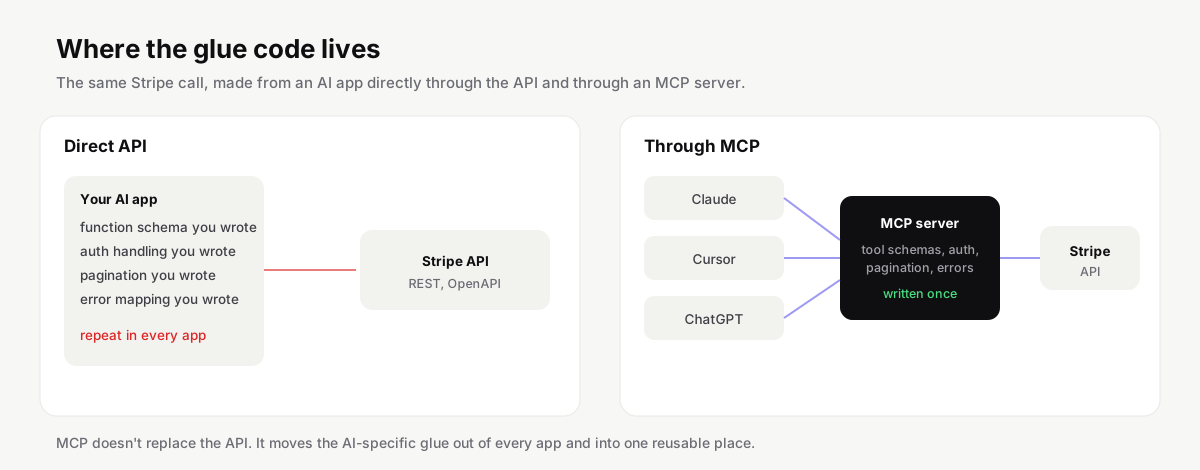
Mit MCP wandert dieser Glue Code in einen einzigen Server. Dieser stellt Tools wie list_charges und create_refund bereit, mit Beschreibungen, die speziell für ein Modell geschrieben wurden. Er verwaltet den Key oder das OAuth Token. Jeder MCP Client – Claude, Cursor, ChatGPT, VS Code – kann sich damit verbinden und das gleiche Verhalten erhalten. Die Stripe API hat sich überhaupt nicht geändert. Was sich geändert hat, ist, wer die KI-spezifischen Teile schreiben muss und wie oft das passiert.
Side by side
| Traditionelle API | MCP | |
|---|---|---|
| Wer ruft es auf | Code, den ein Entwickler geschrieben hat | Ein KI-Modell über eine Host-App |
| Wie der Aufrufer erfährt, was existiert | Dokumentation lesen zur Build-Zeit | Den Server zur Laufzeit fragen (tools/list) |
| Beschreibungen sind geschrieben für | Entwickler | Modelle: was das Tool macht und wann man es nutzt |
| Nachrichtenformat | Variiert: REST, GraphQL, gRPC | JSON-RPC 2.0 für jeden Server |
| Auth | API keys, OAuth, was auch immer der Service nutzt | Env vars für lokale Server, OAuth 2.1 für Remote-Server |
| Umfang der Aktionen | Alles, was die API preisgibt | Nur die Tools, die der Server explizit anbietet |
| Eine Integration funktioniert in | Einer App | Jedem MCP client |
| Typische Latenz | Ein Network Hop | Ein zusätzlicher Hop über den Server |
Zwei Zeilen verdienen mehr Aufmerksamkeit, als sie normalerweise bekommen.
Discovery ist der eigentliche Unterschied. Ein Programm, das eine API aufruft, fragt zur Laufzeit nie "was kannst du tun?"; der Entwickler wusste das bereits. Ein Modell muss das tatsächlich fragen, in jeder Session, und es braucht die Antwort in Worten, über die es schlussfolgern kann. Deshalb liest sich eine MCP tool Beschreibung eher wie ein Ratschlag ("Nutze dies, um offene Pull Requests zu finden, die einen bestimmten Pfad betreffen") als wie eine Referenzdokumentation.
Der Scope ist ein Sicherheitsfeature. Ein API key für einen Service gewährt normalerweise alles, was dieser Key tun darf. Ein MCP server entscheidet, welche Aktionen überhaupt existieren. Ein Read-only Analytics Server kann einfach kein delete tool anbieten. Du bekommst keine vergleichbare Garantie, wenn du einem Modell einfach sagst "bitte lösche nichts".
MCP vs function calling
Function calling – oder Tool Use, wie manche Anbieter es nennen – ist ein Feature einer Modell-API: Du listest Funktionen in deinem Request auf, und das Modell kann mit einer Antwort wie "rufe diese Funktion mit diesen Argumenten auf" reagieren. Das wird oft mit MCP verwechselt, weil MCP am Ende genau darauf aufbaut.
So spielen die beiden zusammen: Deine Host-App, zum Beispiel Claude Code, verbindet sich mit MCP servern und sammelt deren Tools. Wenn die App einen Request an das Modell sendet, übergibt sie diese Tools als Funktionsdefinitionen. Wenn das Modell den Aufruf einer Funktion verlangt, leitet die Host-App diesen Aufruf an den richtigen MCP server weiter und spielt das Ergebnis zurück. Function calling ist also die modellseitige Hälfte, während MCP der Standard für alles auf der anderen Seite ist: wie Tools über verschiedene Anbieter hinweg beschrieben, gefunden, autorisiert und aufgerufen werden.
Wenn du nur ein einzelnes Feature in einer App mit einem Modell baust, ist einfaches Function calling weniger Aufwand und völlig ausreichend. MCP lohnt sich dann, wenn dasselbe Tool in vielen verschiedenen Apps funktionieren soll oder wenn du möchtest, dass Nutzer ihren eigenen AI-Client mitbringen können.
| Function calling | MCP | |
|---|---|---|
| Was es ist | Ein Feature einer einzelnen Modell-API | Ein Protokoll zwischen AI-Apps und Tool-Servern |
| Wo Tools definiert werden | Im Request deiner App an das Modell | In einem separaten Server, mit dem jeder Client sich verbinden kann |
| Funktioniert in | Der App, die du geschrieben hast | Jedem MCP Client |
| Discovery | Du übergibst die Liste bei jedem Request | Der Client fragt den Server zur Laufzeit ab |
| Ideal für | Ein Feature, eine App, ein Modell | Tools, die über Apps, Agents und Anbieter hinweg geteilt werden |
Wann eine API die richtige Wahl ist
Verzichte auf MCP, wenn kein Modell involviert ist. Ein Web-Frontend, eine mobile App, ein nächtlicher Sync-Job oder eine Partner-Integration sollten direkt mit deiner API kommunizieren. Das Hinzufügen eines MCP-Layers bringt hier keinen Vorteil und erzeugt nur einen zusätzlichen Hop.
Verzichte darauf, wenn du die präzise Kontrolle über jeden einzelnen Aufruf benötigst. Zahlungsabwicklungen, Massenlöschungen oder alles, was einen manuell geschriebenen Code-Pfad mit Tests und Audit Trails erfordert, gehört in normalen Code, der die API aufruft – selbst wenn eine KI dir beim Schreiben dieses Codes geholfen hat.
Und verzichte darauf, wenn das Modell nur Daten benötigt, die du bereits vorliegen hast. Wenn deine App einen Kundendatensatz abruft und ihn in den Prompt kopiert, ist das kein Tool, sondern Context, und benötigt keinen Server.
| Situation | Nutzen |
|---|---|
| Ein Web- oder Mobile-Frontend ruft dein Backend auf | Die API |
| Ein nächtlicher Sync oder eine Partner-Integration | Die API |
| Zahlungen, Massenlöschungen oder alles, was einen Audit Trail benötigt | Die API, über getesteten Code |
| Deine App hat die Daten bereits und kopiert sie in den Prompt | Keines von beiden; das ist Context, kein Tool |
| Ein KI-Feature innerhalb einer App, die du kontrollierst | Function calling |
| Ein Modell soll entscheiden, was es nachschlagen oder tun soll | MCP |
| Deine Kunden nutzen Claude, Cursor und ChatGPT | MCP, idealerweise ein hosted Server |
| Mehrere interne Agents benötigen dasselbe System | Ein gemeinsamer MCP server |
Wann MCP die richtige Wahl ist
Greif zu MCP, wenn ein Modell selbst entscheiden soll, was zu tun ist. Agents, die Informationen nachschlagen, Tickets eröffnen, Datenbanken abfragen oder einen Deploy prüfen, benötigen Tools – und MCP ist der Standardweg, um ihnen diese Tools zur Verfügung zu stellen.
Es ist auch die richtige Entscheidung, wenn dein Produkt in den KI-Tools anderer Leute funktionieren soll. Wenn deine Kunden Claude, Cursor und ChatGPT nutzen, reicht ein einziger MCP server aus, um alle zu erreichen. Deshalb veröffentlichen Unternehmen wie GitHub, Linear, Notion und Stripe ihre eigenen. Auf HostedMCP kannst du offizielle Server nach Produkt durchsuchen und sehen, welche gehostet werden und welche lokal laufen.
Zudem hilft es, wenn du intern mehrere Agents betreibst. Ein MCP server pro System, der von jedem Agent geteilt wird, lässt sich viel einfacher absichern und aktualisieren, als Tool-Code, der in jeden einzelnen Agent kopiert wurde.

Sicherheit ist hier anders
APIs und MCP server sind unterschiedlichen Bedrohungen ausgesetzt, vor allem weil ein Modell in den Prozess involviert ist.
Bei einer API ist der Aufrufer dein Code, und er tut genau das, was du geschrieben hast. Bei MCP ist der Aufrufer ein Modell, das unvertrauenswürdigen Text liest: Webseiten, E-Mails, Issue-Kommentare. Ein geschickt formulierter Issue-Kommentar kann versuchen, das Modell dazu zu bringen, ein Tool aufzurufen, das es eigentlich nicht nutzen sollte. Das ist Prompt Injection. Deshalb fragen gute Hosts nach, bevor sie Tools ausführen, die Daten verändern, und deshalb sollten Server nur das kleinstmögliche Set an nützlichen Tools bereitstellen.
Die MCP-Spezifikation zieht auch bei Tokens eine klare Grenze. Gemäß den Security Best Practices darf ein Server keine Tokens akzeptieren, die nicht explizit für diesen Server ausgestellt wurden, und er darf das Token eines Users nicht an einen anderen Service weiterreichen. Dieses Anti-Pattern hat einen Namen: Token Passthrough. Das ist eines der ersten Dinge, die man im Code eines Servers prüfen sollte, bevor man ihm vertraut. Bei Remote-Servern folgt die Autorisierung OAuth 2.1, und die Revision vom 28.07.2026 verschiebt die Client-Registrierung zu Client ID Metadata Documents. Mehr dazu findest du in unserem MCP Security Guide.
Achtung
Behandle jedes Argument, das ein MCP Tool erhält, als unvertrauenswürdigen Input. Das Modell, das das Argument gewählt hat, könnte eine Webseite oder einen Issue-Kommentar gelesen haben, der darauf ausgelegt war, es zu manipulieren.
Performance und Kosten
Manchmal gibt es Bedenken, dass MCP langsam sein könnte. Ein lokaler Server fügt lediglich einen Aufruf an einen Prozess auf derselben Maschine hinzu, und ein Remote-Server verursacht einen HTTP-Roundtrip. Beides ist im Vergleich zu den Sekunden, die ein Modell für die Generierung der Antwort benötigt, vernachlässigbar.
Die Kosten, die wirklich entscheidend sind, sind der Context. Jedes Tool, das der Host lädt, kommt mit einer Beschreibung und einem Schema, das das Modell lesen muss, und jedes Tool-Ergebnis landet im Gesprächsverlauf. Ein Server mit achtzig sehr ausführlichen Tools kann einen spürbaren Teil des Context Windows beanspruchen, noch bevor du überhaupt etwas gefragt hast. Das ist einer der Gründe, warum wir auf jeder Server-Seite bei HostedMCP die vollständige Tool-Liste anzeigen: Du kannst sehen, wie groß ein Server ist, bevor du ihn installierst, und dich für einen kleineren entscheiden, falls ein spezialisierter Server denselben Job erledigt.
Eine API in einen guten MCP server verwandeln
Die verlockende Abkürzung ist es, aus einer OpenAPI-Datei pro Endpoint ein Tool zu generieren. Es gibt Tools, die genau das tun, und sie sind nützlich für einen schnellen Prototyp. Sie ergeben aber selten einen guten Server. Wenn du dir ein paar Listings mit ein paar hundert fast identischen Tools ansiehst, erkennst du das Problem: Das Modell muss jedes einzelne davon lesen, und die meisten davon bilden Endpoints ab, nach denen man in einem Gespräch niemals fragen würde.
Ein Modell denkt nicht in Endpoints. Es denkt in Aufgaben. "Finde den Kunden, der wegen Rechnung 1042 eine E-Mail geschrieben hat, und zeig mir seine letzten drei Abbuchungen" ist eine Aufgabe, die mehrere Endpoints umfasst. Ein guter Server bietet Tools auf dieser Ebene an: find_customer, das eine E-Mail, eine Rechnungsnummer oder einen Namen akzeptiert, und recent_charges, das eine kurze, lesbare Zusammenfassung zurückgibt, anstatt das rohe JSON mit vierzig Feldern.
| Endpoint-basiertes Tool | Aufgaben-basiertes Tool |
|---|---|
GET /customers?email= |
find_customer, das eine E-Mail, Rechnungsnummer oder einen Namen akzeptiert |
GET /charges?customer= mit 40 Feldern |
recent_charges, das eine kurze, lesbare Zusammenfassung zurückgibt |
| Ein Tool pro Endpoint, hunderte insgesamt | Eine Handvoll Tools, die genau das abdecken, was Nutzer fragen |
| Beschreibungen direkt aus der Dokumentation kopiert | Beschreibungen, die erklären, wann man das Tool einsetzen soll |
A few habits make a big difference.
-
Schreibe Beschreibungen für das Modell. Sag, wofür das Tool gedacht ist und wann man es benutzt, nicht nur, was es zurückgibt. "Nutze dieses Tool vor einer Rückerstattung, um sicherzustellen, dass die Abbuchung zum Kunden gehört" ist für ein Modell wertvoller als eine bloße Liste von Feldern.
-
Gib weniger zurück. Kürze die Antworten auf die Felder, die ein Mensch tatsächlich anschauen würde, und nutze Pagination mit einem klaren Cursor. Jedes zusätzliche Feld kostet Context und erhöht die Chance, dass das Modell etwas falsch liest.
-
Mache gefährliche Tools offensichtlich. Benenne sie klar, zum Beispiel
delete_project, und nutze die Read-only- und Destructive-Hints, die die Spec bereitstellt, damit Hosts um Bestätigung bitten können. Noch besser: Lass destruktive Aktionen in der ersten Version ganz weg. -
Validiere alles. Argumente kommen von einem Modell, das unvertrauenswürdigen Text gelesen hat. Überprüfe Typen, Bereiche und Besitzverhältnisse im Server, genau so, wie du es bei jedem öffentlichen Endpoint tun würdest.
Welches solltest du also bauen?
Wenn du noch keine API hast, baue zuerst die API. Deine eigene App, Skripte und Partner werden sie sowieso brauchen, und ein MCP server ohne eine solide API im Hintergrund neigt dazu, zu einer zweiten, schlechteren API zu werden.
Wenn du bereits eine API hast und möchtest, dass KI-Tools dein Produkt nutzen, schalte einen MCP server davor. Starte mit einer Handvoll Tools, die genau das abdecken, wonach die Leute tatsächlich fragen. Schreibe die Beschreibungen für ein Modell statt für einen Entwickler und biete es nach Möglichkeit sowohl als lokales Package als auch als hosted Endpoint an. Unser Guide zum Bauen eines MCP server führt dich mit den aktuellen SDKs durch den Prozess in TypeScript und Python.
Wenn du nur ein einzelnes KI-Feature innerhalb einer App benötigst, die du selbst kontrollierst, reicht Function Calling heute völlig aus. Du kannst diese Funktionen später ohne Änderungen an der zugrunde liegenden API zu einem MCP server erweitern.
Wie es jetzt weitergeht
Um zu sehen, wie das in der Praxis aussieht, öffne ein paar Server, die bekannte APIs kapseln, wie zum Beispiel den GitHub server oder einen der Postgres servers, und vergleiche deren Tool-Listen mit der zugrunde liegenden API-Dokumentation. Du wirst merken, wie viel sie – ganz bewusst – weglassen. Wenn du neu beim Protocol bist, fang am besten mit was MCP ist an, und wenn du einfach nur eines ausprobieren willst, zeigen dir unsere client guides die exakte Config für deinen Editor.