
Transforme des sources web et des documents en un contexte versionné et cité que les clients IA peuvent interroger, comparer et exporter.
Aussi connu sous raintree-technology/docpull
- Étoiles
- 29
- Outils
- —
- Téléchargements, 30 jours
- 762
- Dernière version
- 6.10.0
- Dernier commit
- 13 nov. 2026
- Licence
- MIT
Qu'est-ce que DocPull MCP ?
DocPull est un serveur MCP. Transforme des sources web et des documents en un contexte versionné et cité que les clients IA peuvent interroger, comparer et exporter.
Résumé généré à partir du README du projet
À propos du MCP server DocPull
DocPull permet de transformer des pages web et des documents en un contexte cité et versionné pour les agents IA. Il permet aux développeurs de capturer des sources web publiques, telles que de la documentation, des dépôts GitHub ou des pages de politiques, pour les convertir en archives reproductibles qu'une IA peut interroger avec des segments de sources exacts. Ce processus aide à garantir que les réponses d'un agent s'appuient sur des preuves spécifiques et vérifiables plutôt que sur du contenu web changeant.
S'exécutant localement via un serveur Python stdio, l'outil ne nécessite aucun compte payant ni service hébergé pour fonctionner. Les utilisateurs peuvent gérer les sources via une CLI ou intégrer ces fonctionnalités dans des applications en utilisant un SDK Python ou TypeScript. Lorsqu'il est connecté à un client MCP comme Claude Code, il fournit à l'agent des outils pour récupérer, synchroniser et comparer le contenu. Le système utilise un mécanisme de lockfile pour suivre les hashs de contenu et les URL des sources, ce qui permet de détecter facilement quand une documentation a dérivé par rapport aux versions précédentes.
Ce que vous pouvez faire avec
- 1Détection des changements de documentationComparez la documentation web actuelle avec les versions précédemment sauvegardées pour identifier les mises à jour ou les dérives.
- 2Fourniture de contexte cité aux agentsRécupérez des passages spécifiques et dédupliqués à partir d'une archive verrouillée pour répondre aux questions avec des citations précises.
- 3Exportation de contexte pour les outils de développementPréparez et transférez la documentation collectée vers des formats spécialisés pour une utilisation dans différents environnements IA.
- 4Automatisation des contrôles de qualité de la documentationExécutez des barrières automatisées pour garantir que le contexte collecté respecte des standards spécifiques en matière de couverture de citations et de fraîcheur.
Extrait du README du projet. Chaque cas d'utilisation est vérifié par rapport à une citation du document.
Comment installer DocPull MCP
Formats vérifiés le 10 nov. 2026Ajouter à CursorAjouter à GooseInstaller DocPull MCP dans Claude Code
$ claude mcp add docpull -- uvx docpullInstaller DocPull MCP dans Cursor
~/.cursor/mcp.json
{
  "mcpServers": {
    "docpull": {
      "command": "uvx",
      "args": [
        "docpull"
      ]
    }
  }
}Installer DocPull MCP dans VS Code
.vscode/mcp.json
{
  "servers": {
    "docpull": {
      "type": "stdio",
      "command": "uvx",
      "args": [
        "docpull"
      ]
    }
  }
}Installer DocPull MCP dans VS Code CLI
$ code --add-mcp '{"name":"docpull","type":"stdio","command":"uvx","args":["docpull"]}'Installer DocPull MCP dans Claude Desktop
claude_desktop_config.json
{
  "mcpServers": {
    "docpull": {
      "command": "uvx",
      "args": [
        "docpull"
      ]
    }
  }
}Installer DocPull MCP dans Codex
$ codex mcp add docpull -- uvx docpullInstaller DocPull MCP dans Codex config.toml
~/.codex/config.toml
[mcp_servers.docpull]
command = "uvx"
args = ["docpull"]
Installer DocPull MCP dans Gemini CLI
$ gemini mcp add -s user docpull uvx -- docpullInstaller DocPull MCP dans Gemini settings.json
~/.gemini/settings.json
{
  "mcpServers": {
    "docpull": {
      "command": "uvx",
      "args": [
        "docpull"
      ]
    }
  }
}Vérifications automatisées
Exécuté le 14 nov. 2026Rapport complet →A passé nos vérifications automatisées. Il ne s'agit pas d'un audit de sécurité : lisez le code et donnez au serveur l'accès le plus restreint dont il a besoin. Fonctionnement des vérifications

- Dépôt source lié et accessibleraintree-technology/docpull is public and reachablegithub.com/raintree-technology/docpull ↗Réussi
- Le nom du package correspond au dépôt sourcedocpull names raintree-technology/docpull as sourcepypi.org/project/docpull/ ↗Réussi
- Provenance du build (attestation Sigstore)Sigstore attestation for docpullpypi.org/project/docpull/ ↗Réussi
- Licence open source (OSI)MITspdx.org/licenses/MIT.html ↗Réussi
- Commit ou version publiée au cours de l'année écouléeLast commit or release 2026-11-13github.com/raintree-technology/docpull ↗Réussi
- OpenSSF ScorecardNon vérifié
- Nom du package non proche d'un package populaireNo popular package one edit away from docpullRéussi
- Aucun avis critique dans le package ou ses dépendancesthe package checked; no critical advisoryosv.dev ↗Réussi
- Aucune instruction cachée destinée au modèle0 tool descriptions and the README read; no override phrases, credential paths or hidden charactersRéussi
- Les outils destructifs sont étiquetésNon vérifié
- Le point de terminaison distant répond à la poignée de main MCPNon vérifié
README
Voir sur GitHubDocPull
Active open-source project · MIT License
DocPull turns changing public web sources into cited, reproducible context for AI agents and retrieval pipelines. Use it when your application needs to know which sources it used, whether they changed, and how to rebuild the same context later.


Install and sync your first source
pip install docpull
docpull init stripe-docs
docpull add https://docs.stripe.com
docpull sync
docpull query "retry policy" --max-tokens 4000
docpull diff
docpull export context-pack --target cursor
The project stores declared sources in docpull.yaml and resolved inputs in
.docpull/context.lock.json. Later syncs produce a hash-based diff while preserving
source URLs, content hashes, run IDs, citations, and export metadata.
docpull query retrieves deduplicated passages from locked archives with version
filters, a response budget, and exact source spans. The same query is available
through the Python SDK and MCP. See Query locked context
for budget semantics and queries across projects.
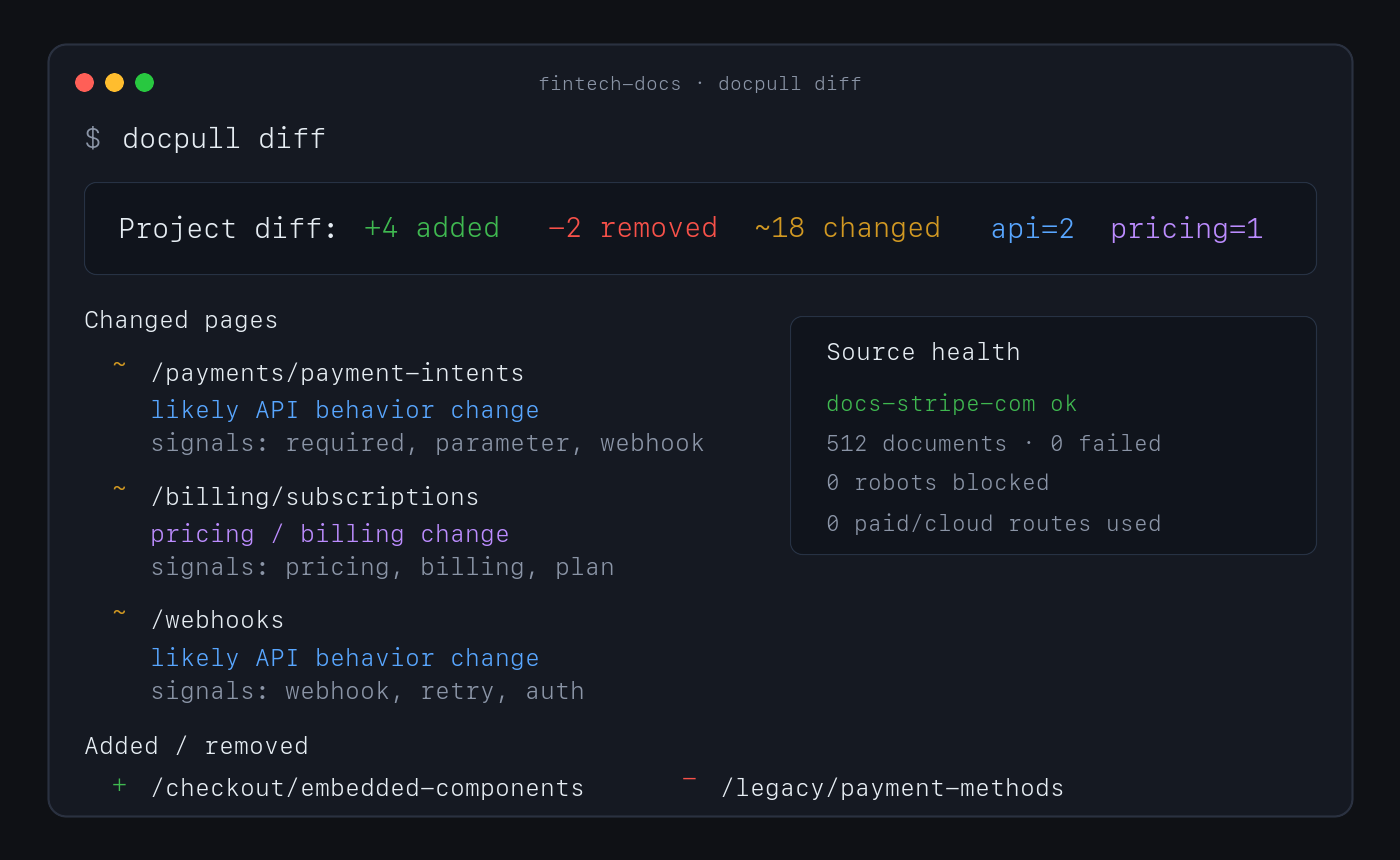
No account or paid API is required for this path. Direct fetching, discovery, extraction, indexing, pack analysis, and diffs run locally.
Why use DocPull
- Reproduce agent context. Stable IDs, hashes, manifests, and lockfiles show which source versions produced an answer or artifact.
- Detect source drift. Sync and diff documentation, product pages, policies, feeds, repositories, packages, standards, and local documents.
- Keep evidence inspectable. Markdown, NDJSON, SQLite, citations, and provenance sidecars remain readable without a hosted service.
- Choose the downstream surface. Export context for agent clients, vector import, data workflows, or a versioned context-pack release.
- Keep expensive routes explicit. Browser and cloud rendering require an explicit choice and can be blocked with a zero-dollar budget.
How it works
declared sources → local acquisition → versioned evidence → diff and validation → export
DocPull's v3 pack contract separates raw extraction, agent-ready context, and eval-grade evidence. Validate the level a downstream system requires:
docpull pack prepare packs/docs --eval-grade
docpull pack validate packs/docs --level eval
docpull ci --prepare
docpull ci checks freshness, citation coverage, pack quality, rights metadata, and
other configured gates. It writes context-ci.report.json and CONTEXT_CI.md, then
exits non-zero when a hard gate fails.
Supported surfaces
| Surface | Use it for | Start here |
|---|---|---|
| CLI | Fetch, sync, diff, validate, and export | docs/cli-recipes.md |
| Python SDK | Embed acquisition in Python applications | docs/surface-contract.md |
| MCP server | Give local agent clients source tools | MCP server |
| TypeScript SDK | Read local packs and invoke the CLI from Node or Bun | sdk/js/README.md |
| Agent plugin | Install the supported MCP workflow in an agent client | plugin/README.md |
Common source shapes include static and server-rendered websites, OpenAPI documents, feeds, papers, public GitHub repositories, npm and PyPI packages, standards, datasets, transcripts, Wikimedia pages, product and policy pages, and local PDF or office files. See context-pack workflows for the complete surface.
MCP server
pip install 'docpull[mcp]'
docpull mcp
Claude Code can register the same local server:
claude mcp add --transport stdio docpull -- docpull mcp
The Python stdio server is the supported MCP server.
Limits and security boundary
DocPull is an evidence-acquisition engine, not a hosted competitive-intelligence product. It owns fetching, explicit rendering adapters, versioning, citations, hashing, validation, replay, and export. Downstream products own scheduling, human review, approved claims, legal conclusions, accounts, and notifications.
The default path does not handle complex interactive browser workflows, CAPTCHAs, stealth scraping, or private dashboards. JavaScript rendering is explicit. Authenticated sources require environment-variable references; DocPull does not persist credential values in project artifacts.
Security defaults include HTTPS-only fetching, robots.txt compliance, SSRF and DNS rebinding protections, redirect guards, XXE protection, and path-traversal checks. Read the web-source boundary, security posture, and evidence-engine decision before extending acquisition behavior.
Documentation and evidence
- CLI recipes — Common commands and advanced workflows.
- Context dependencies — Project and lockfile model.
- Context Pack Contract v3 — Artifact levels and compatibility.
- Public contracts — Schemas and versioning rules.
- Alternatives — Browser automation and hosted extraction tradeoffs.
- JavaScript SDK and loaders — TypeScript client and LangChain/LlamaIndex loaders.
- Dependency security — Locked dependency sets and optional parser support.
- Evaluation lab — Reproducible methods, results, and claim boundaries.
- Changelog — Release history.
Raintree open-source system
DocPull owns evidence acquisition and reproducible agent context. It can be used independently; the sibling projects do not imply a required integration or shared release cycle.
| Project | Responsibility |
|---|---|
| Raintree Standards | Defines governed requirements and evidence. |
| Trellis | Enforces shared JavaScript and TypeScript code policy. |
| HIG Doctor | Audits interface source and provides HIG guidance. |
| PolicyStrata | Tests cross-layer policy behavior. |
See the Raintree open-source portfolio for current lifecycle and distribution links.
Raintree also builds BetterOff, which keeps a household's spending, investments, assets, debts, and net worth in one current record.
Project policies
Contributing · Code of Conduct · Security · Metrics and evidence limits · Source repository · MIT License
Questions sur DocPull MCP
Comment ajouter DocPull MCP à Claude Code ?
Exécutez claude mcp add docpull -- uvx docpull dans votre terminal. Ajoutez --scope user pour le rendre disponible dans tous les projets.
Comment ajouter DocPull MCP à Cursor ?
Ouvrez ~/.cursor/mcp.json et ajoutez le serveur sous mcpServers, avec la configuration Cursor indiquée dans la section d'installation ci-dessus.
Comment installer et exécuter le MCP server DocPull ?
Installez l'extension MCP avec pip et lancez docpull mcp, ce qui démarre le serveur local via stdio supporté. Vous pouvez également l'enregistrer auprès de Claude Code en utilisant la commande claude mcp add.
DocPull nécessite-t-il un compte ou une API payante ?
Non. Le chemin par défaut permet de récupérer, extraire, indexer et comparer les données localement, sans compte ni API payante.
DocPull peut-il détecter les changements de sources ?
Oui. Une nouvelle synchronisation génère un diff basé sur un hash qui identifie les sources modifiées tout en préservant les URL, les hashs de contenu, les ID d'exécution et les citations.
Quelles sont les protections de sécurité de DocPull ?
Par défaut, il utilise la récupération via HTTPS uniquement avec respect du robots.txt, des protections contre le SSRF et le DNS rebinding, des gardes contre les redirections, une protection XXE et des vérifications de path-traversal.
Comment sont gérées les sources authentifiées ?
Les identifiants doivent être fournis via des références de variables d'environnement et ne sont pas stockés dans les artefacts du projet.