
MCP server de Remind
Commit 23 oct 2026Proporciona a los agentes de IA una capa de memoria duradera para capturar episodios, curar conceptos y recuperar contexto mediante hechos temporales y búsqueda semántica.
También conocido como sandst1/remind
- Stars
- 84
- Herramientas
- —
- Descargas, 30 días
- —
- Última versión
- —
- Último commit
- 23 oct 2026
- Licencia
- Apache-2.0
¿Qué es Remind MCP?
Proporciona a los agentes de IA una capa de memoria duradera para capturar episodios, curar conceptos y recuperar contexto mediante hechos temporales y búsqueda semántica.
Resumen generado a partir del README del proyecto
Acerca del MCP server de Remind
Remind permite a los desarrolladores que utilizan herramientas como Claude Desktop o Cursor dotar a sus agentes de IA de una capa de memoria duradera. Funciona como un sustrato determinista donde los agentes pueden capturar experiencias brutas como episodios y organizarlas en conceptos generalizados. Al utilizar embeddings locales mediante fastembed, el sistema no requiere API keys para la configuración básica, aunque es compatible con OpenAI para necesidades de embeddings en la nube.
Los usuarios interactúan con la memoria a través de una interfaz de línea de comandos, una REST API o una conexión mediante MCP server. El sistema gestiona hechos temporales, detecta contradicciones mediante la detección de colisiones y permite una curación estructurada del conocimiento. Es compatible con varios backends de almacenamiento, incluyendo archivos JSON locales, SQLite con sqlite-vec, PostgreSQL con pgvector y MySQL. Esto permite que la memoria se versione junto con el código en repositorios Git, asegurando que el contexto acompañe a los cambios de rama y las fusiones.
Qué puedes hacer con él
- 1Capturar decisiones técnicasUn agente puede registrar decisiones arquitectónicas específicas como hechos para evitar contradicciones futuras.
- 2Organizar el conocimiento en conceptosLos desarrolladores pueden transformar múltiples episodios brutos en un único concepto estructurado con título y resumen.
- 3Recuperar contexto semánticoUn cliente de IA puede realizar una búsqueda semántica para responder preguntas basadas en memorias almacenadas.
- 4Gestionar conflictos de memoriaEl sistema identifica cuándo la nueva información choca con hechos existentes, permitiendo un triaje manual.
Escrito a partir del README del proyecto. Cada caso de uso se verifica con una cita del mismo.
Configuración
REMIND_DB_URL
| Nombre | Descripción | Tipo |
|---|---|---|
| REMIND_DB_URL | — |
Verificaciones automáticas
Ejecutado 13 nov 2026Informe completo →Aún no verificado. Un servidor necesita una puntuación de 80, ningún hallazgo grave y suficientes datos para que podamos revisarlo. Cómo funcionan las verificaciones · Qué corregir para obtener más puntos

- Repositorio de origen vinculado y accesibleAprobado
- Licencia de código abierto (OSI)Aprobado
- Commit o lanzamiento en el último añoAprobado
- El nombre del paquete no es similar a un paquete popularNo verificado
- El endpoint remoto usa HTTPSNo verificado
- Las herramientas destructivas están etiquetadasNo verificado
- Sin instrucciones ocultas para el modeloAprobado
- No hay avisos críticos en el paquete ni en sus dependenciasNo verificado
README
Ver en GitHubRemind


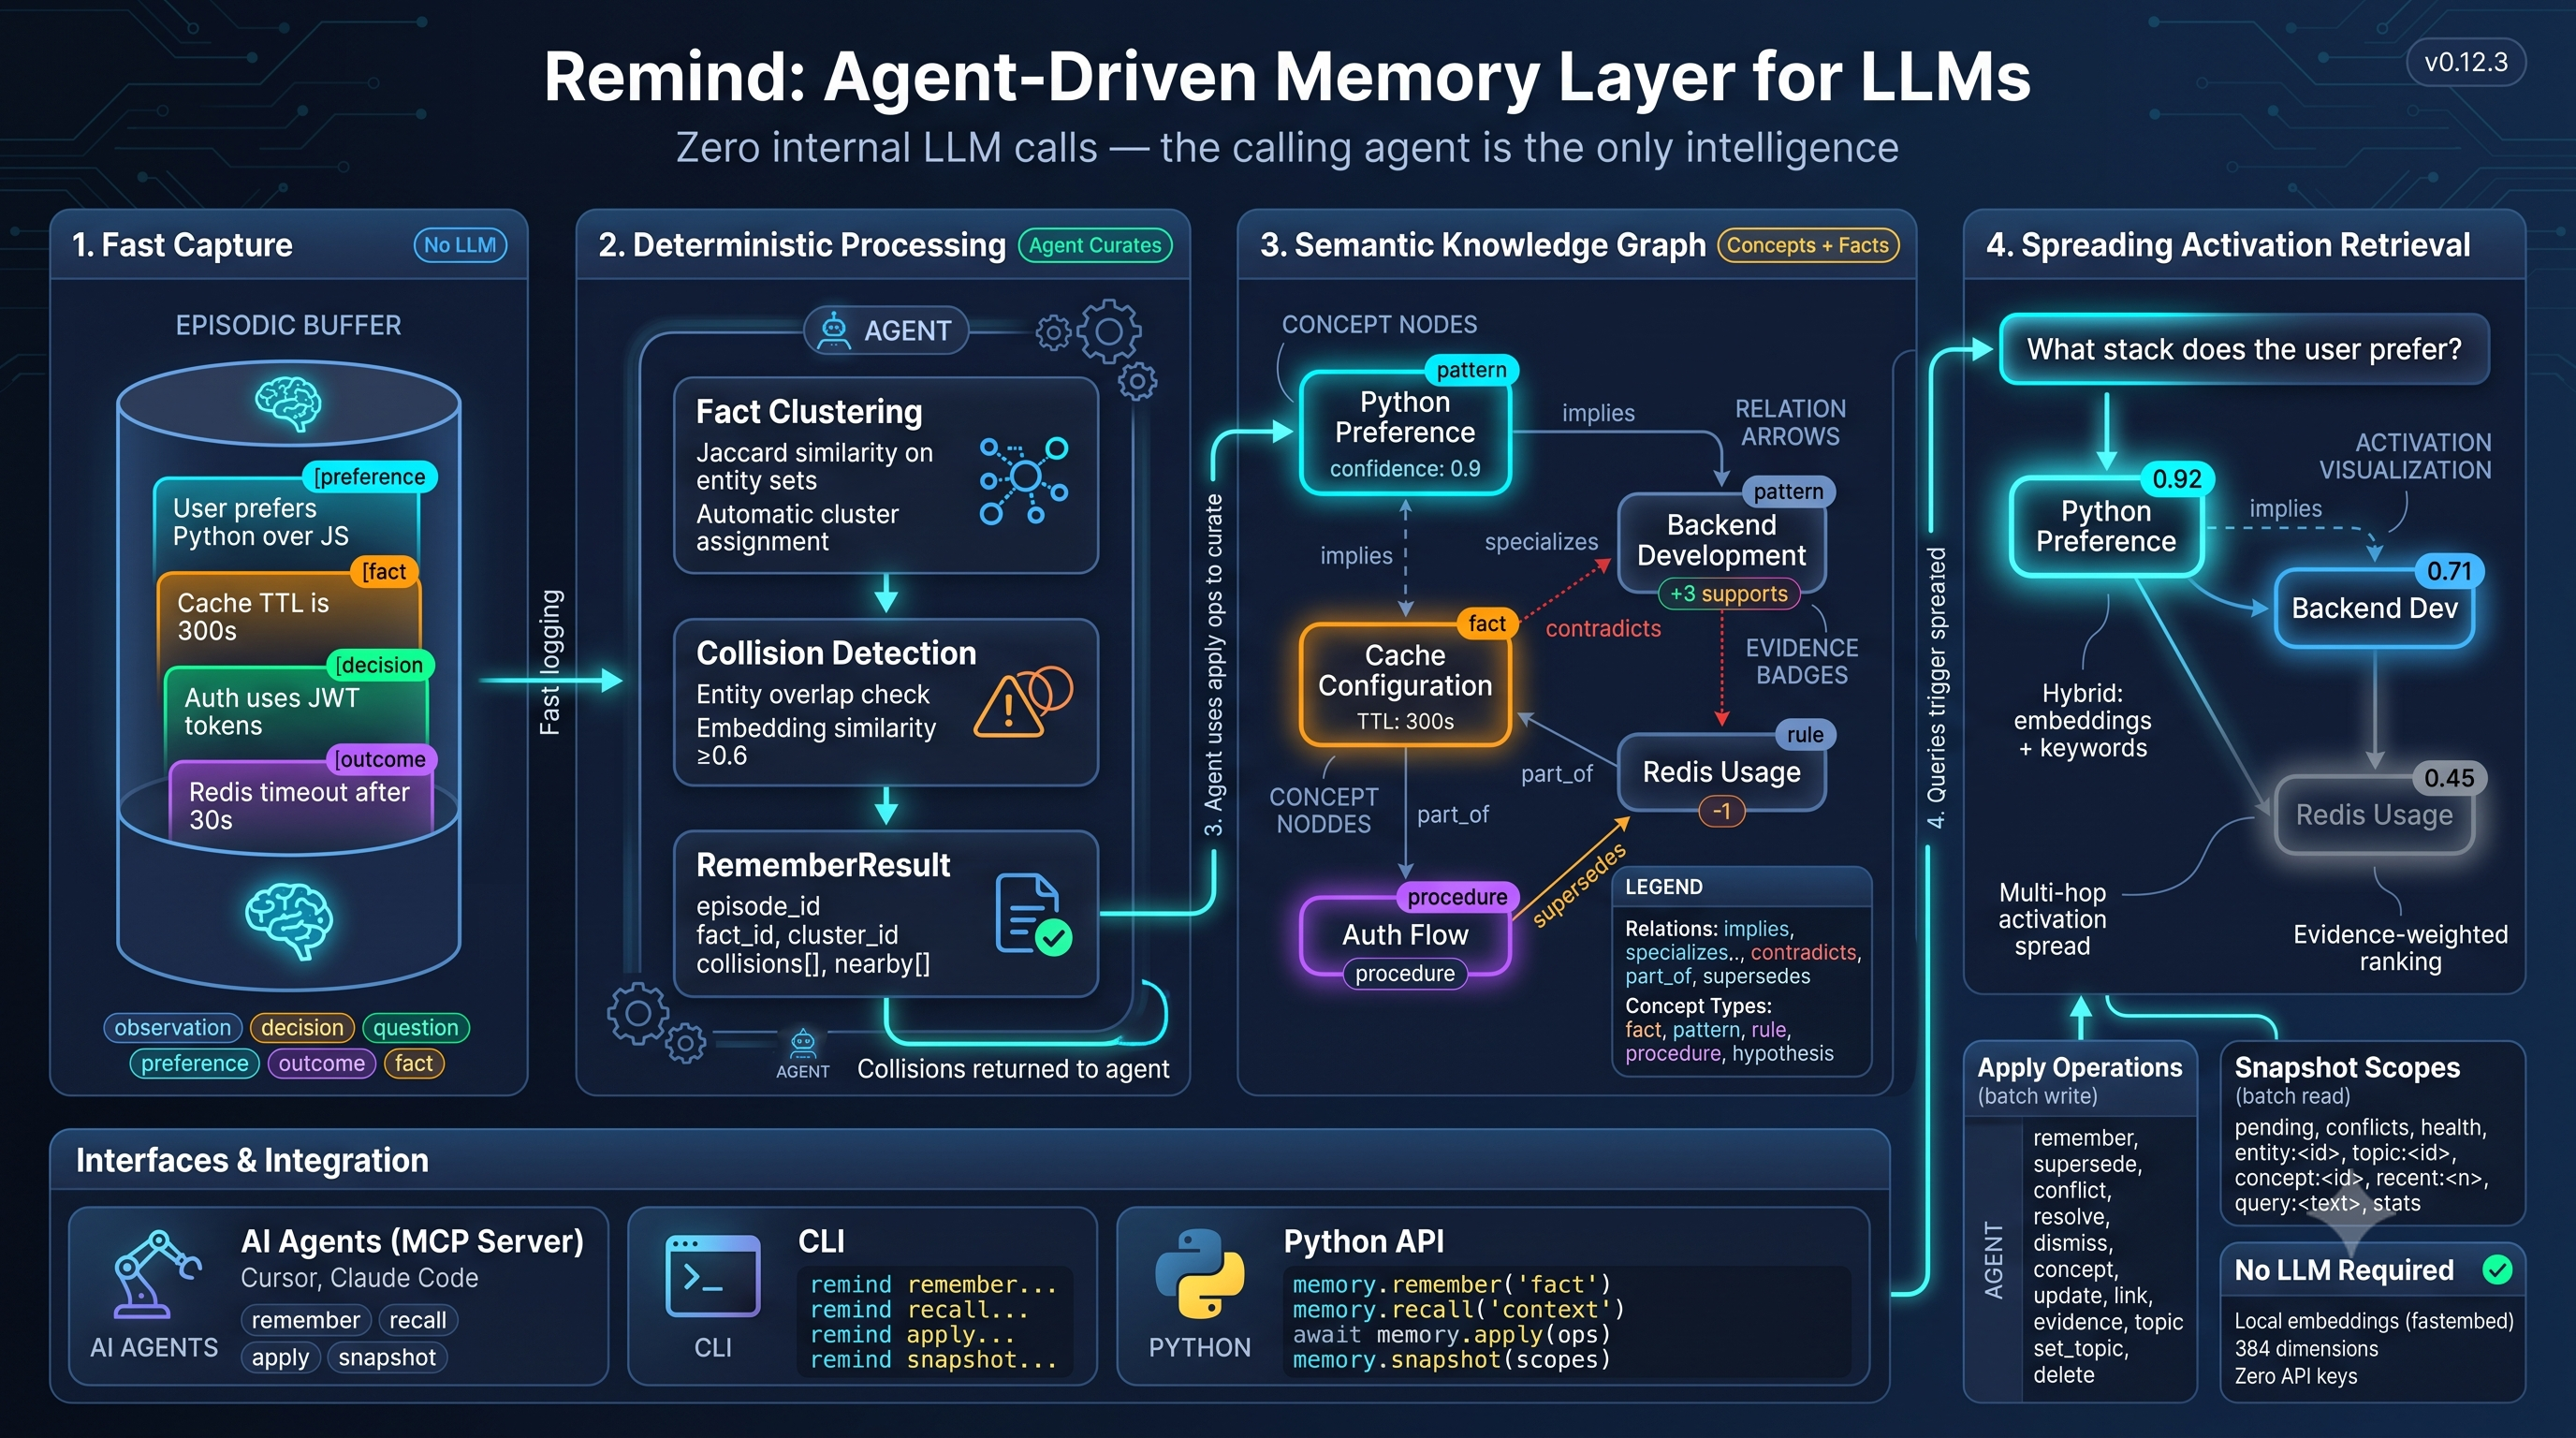
Agent-driven memory layer for LLMs. Remind is a deterministic memory substrate with temporal facts, semantic retrieval, and structured curation — the calling agent is the only intelligence.
Documentation · Examples · Changelog
Quick start
pip install remind-mcp
No configuration required — Remind uses local embeddings by default (fastembed, no API key).
remind remember "This project uses React with TypeScript"
remind remember "Chose PostgreSQL for the database" -t decision
remind remember "Cache TTL is 600 seconds" -t fact -e concept:caching
remind recall "What tech stack are we using?"
Durable local memory
Local memory is stored as deterministic JSON records in .remind/memory/. Commit those files with the code; memories follow branch checkout and merge normally. .remind/cache/ and .remind/runtime/ hold ignored indexes, embeddings, logs, and recovery data. Existing local databases migrate automatically with a retained backup. Explicit sqlite://, PostgreSQL, and MySQL URLs continue selecting SQL directly.
remind --store ./my-memory remember "User prefers concise answers"
remind remember "Cache TTL is 600 seconds" -t fact --json --idempotency-key ttl-change
remind recall "cache configuration" --json --explain
remind doctor
remind export memory.json                # complete portable knowledge
remind export backup.json --mode backup  # also include embeddings and usage
Edits now require revisions from snapshot; CLI apply accepts --revisions '{"<id>":"<revision>"}', MCP/Python apply accepts expected_revisions. Read-only recall returns a structured RecallResult in Python; use .text for prompt context. Storage and migration describes the breaking changes.
Local evaluations cover capture → curation → restart → recall through Python, CLI, MCP, and REST. Run remind-eval --suite operational, remind-eval --suite retrieval (real local embeddings), or remind-eval --suite agent --agent-command '<runner command>'. See evals/README.md for datasets, gates, and the external runner contract. No internal LLM calls or CI are introduced.
How it works
Remind stores episodes (raw experiences) and concepts (generalized knowledge). You capture and curate memories explicitly using CLI commands or MCP tools.
For facts (-t fact), Remind automatically:
- Creates a
Factrow with validity tracking - Assigns it to a cluster based on entity overlap (Jaccard similarity)
- Detects potential collisions with existing facts — same-cluster collisions and cross-cluster related facts are returned with ready-to-paste
applycommands
For any remember call, the output also surfaces the top-5 nearest episodes and concepts semantically, so you can catch contradictions before they go unnoticed.
For patterns and concepts, you use remind apply to create them from episodes:
remind apply --revisions '<ID-to-revision JSON from snapshot>' << 'EOF'
concept from=ep:11,ep:12 title="Retry-with-backoff for resilience" "Exponential backoff resolves flaky deploys and API timeouts."
processed ids=ep:11,ep:12
EOF
Two batch tools
remind snapshot — Read state
remind snapshot stats pending conflicts health        # Full overview
remind snapshot entity:concept:caching                # Everything about an entity
remind snapshot concept:abc123                        # Concept detail with history

# Browse scopes (for exploring memory)
remind snapshot concepts                              # All concepts
remind snapshot episodes:20                           # Recent 20 episodes
remind snapshot entities:person                       # Entities filtered by type
remind snapshot labels                                # All labels with counts
remind snapshot decisions questions                   # Episodes by type
remind snapshot bootstrap                              # Query-free stable context
Returns JSON. Combinable scopes:
| Scope | Description |
|---|---|
pending |
Unprocessed episodes with their entities |
conflicts[:<status>] |
Open conflicts (or resolved/dismissed/all) |
health |
Actionable issues: pending episodes, open conflicts, orphan concepts |
stats |
Memory statistics |
concepts[:<n>] |
All concepts (default 50) |
episodes[:<n>] |
Recent episodes (default 20) |
entities[:<type>] |
All entities with mention counts, filterable by type |
labels |
All distinct key/value labels in use, with counts |
decisions[:<n>] |
Recent decision episodes |
questions[:<n>] |
Recent question episodes |
entity:<id> |
Episodes and concepts for a specific entity |
label:<key>=<value> |
All episodes and concepts carrying a label |
concept:<id> |
Concept detail with facts and supersession history |
recent:<n> |
N most recent episodes |
query:<text> |
Semantic search results |
events[:<since_seq>] |
Change-feed events with seq > since_seq (default 0). Prefer remind events. |
bootstrap[:<n>] |
Query-free stable context: top-n actionable concepts by confidence + open conflicts + stats (default 10) |
remind events — Poll the change feed
remind events                    # All events from the start
remind events --since 42         # Only events after seq 42
remind events --kind conflict_opened --since 42
Every write (remember, supersede, conflict, resolve, dismiss, concept, update, label, unlabel, delete, restore, processed) appends an append-only row atomically with the write it describes. Returns {since_seq, count, events, next_since_seq} — pass next_since_seq back in as --since on the next poll instead of re-scanning snapshot pending.
remind apply — Write changes
remind apply << 'EOF'
remember as=f1 t=fact e=concept:cache "Cache TTL is 600 seconds"
supersede old=fact:old123 new=$f1
concept as=c1 from=ep:1,ep:2 title="Pattern name" "Summary"
evidence concept=$c1 episode=ep:3 type=supports strength=0.8 "confirms pattern"
resolve id=conflict:7 winner=fact:abc "confirmed by alice"
processed ids=ep:1,ep:2
EOF
All operations run in a single transaction. --dry-run validates without executing.
Operations:
| Op | Description |
|---|---|
remember |
Store episode (same params as CLI remember) |
supersede old=<fact> new=<fact> |
Replace old fact — auto-records resolved conflict |
conflict fact_a=<id> fact_b=<id> |
Flag contradiction for triage |
resolve id=<conflict> winner=<fact> |
Resolve conflict; losing fact is superseded |
dismiss id=<conflict> |
Dismiss conflict (both facts stay active) |
concept from=<eps> title="..." "summary" |
Create concept from episodes |
link from=<concept> to=<concept> type=<relation> |
Add concept relation |
evidence concept=<id> episode=<id> type=<supports|contradicts|qualifies> |
Link episode evidence to concept |
unlink concept=<id> episode=<id> |
Remove evidence link |
entity_relation source=<id> target=<id> relation=<type> |
Create entity graph edge |
reshape id=<concept> type=<new_type> |
Change concept type |
merge from=<id1>,<id2> into=<new_id> |
Combine overlapping concepts |
split id=<concept> into=<id1>,<id2> |
Separate distinct concerns |
update id=<id> [field=value...] |
Update episode or concept fields |
label id=<id> key=<key> value=<value> |
Add a key=value label to episode/concept |
unlabel id=<id> key=<key> value=<value> |
Remove a key=value label from episode/concept |
delete id=<id> / restore id=<id> |
Soft delete / restore |
processed ids=<ep1>,<ep2> |
Mark episodes as reviewed |
Agent skills
Install skills to teach AI agents how to use Remind:
remind skill-install
remind skill-install --agent claude       # Use .claude/skills instead
remind skill-install --dir ~              # Install into ~/.agents/skills
remind skill-install --agent cursor --dir /path/to/project
By default, skills go into .agents/skills under the current working directory.
Use --agent agents|claude|cursor|codex|opencode to select a layout and --dir
to choose any base folder. Codex uses .agents/skills; OpenCode uses
.opencode/skills in projects and .config/opencode/skills when targeting home.
Re-running the command overwrites installed skill files with the bundled versions.
Three skills:
- remind-capture — When and how to write memories (includes decision tree and entity type guide)
- remind-context — When and how to recall before acting (includes output interpretation guide)
- remind-curate — How to process pending episodes into concepts, resolve conflicts, maintain quality
MCP Server
For IDE agents (Cursor, Claude Desktop, etc.):
remind-mcp --port 8765
{
  "mcpServers": {
    "remind": {
      "url": "http://127.0.0.1:8765/sse?db=my-project"
    }
  }
}
Tools: remember, recall, snapshot, apply, plus conflict/entity management.
Web UI at http://127.0.0.1:8765/ui/, REST API at /api/v1/.
Key features
- Zero-config embeddings — Local fastembed by default (no API key required)
- Labels as a substrate primitive — Freeform
key=valuetags on episodes/concepts, pushed down as a pre-filter into vector search (recall -l key=value), not just a post-filter - Change feed — Append-only
eventstable written atomically with every write; poll withremind events --since <seq>instead of re-scanning pending state - Query-free bootstrap read —
snapshot bootstrapreturns deterministic, stable context (top concepts + conflicts + stats) with no embedding call, cheap enough to inject every turn - Temporal facts — Validity windows, structural supersession, time-travel queries (
--as-of) - Collision detection — Same-cluster and cross-cluster collisions reported on write with ready-to-paste
applycommands - Nearby surfacing — Every
remembercall returns the top-k semantically nearest episodes and concepts for immediate conflict triage - Evidence-weighted retrieval — Episodes link to concepts with typed relationships (
supports,contradicts,qualifies); more evidence = higher recall rank - Freeform concept types — Concepts can have any type string:
pattern,rule,procedure,hypothesis, or any domain-specific label - Concept evolution —
reshape(change type),merge(combine overlapping),split(separate concerns), all with lineage tracking - Transactional writes —
applyruns all operations atomically - Spreading activation retrieval — Queries activate related concepts through the knowledge graph
- Native vector indexes — sqlite-vec (SQLite), pgvector (PostgreSQL)
- Entity graph — Files, functions, people, tools linked to episodes and concepts via
entity_relation - Memory decay — Rarely-recalled concepts fade
- Soft delete / restore — With permanent purge as a separate step
- Web UI — Dashboard, concept graph, entity explorer
Embedding providers
Local embedding is the default (384-dim all-MiniLM-L6-v2). For cloud embeddings:
pip install "remind-mcp[openai]"   # OpenAI embeddings
pip install "remind-mcp[rerank]"   # Cross-encoder reranking
{
  "embedding_provider": "openai",
  "openai": { "api_key": "sk-..." }
}
Database backends
Local JSON records are the default; SQLite is used for disposable indexes. Explicit SQL URLs select a database backend. For PostgreSQL or MySQL:
pip install "remind-mcp[postgres]"   # PostgreSQL (psycopg v3 + pgvector)
pip install "remind-mcp[mysql]"      # MySQL (PyMySQL)
export REMIND_DB_URL="postgresql+psycopg://user:pass@localhost:5432/mydb"
CLI reference
Core
  remember     Add an episode (-t type, -e entity, -l key=value label, --asserted-by, --source-ref)
  recall       Semantic or entity-based retrieval (-k, --episode-k, -l label filter, --as-of)
  snapshot     Read memory state as JSON (combinable scopes)
  apply        Apply a batch changeset transactionally

Inspection
  inspect      List or detail concepts; use --episodes for episodes
  stats        Memory statistics
  entities     List entities or show details

Episode types
  decisions    Show decision episodes
  questions    Show open question episodes

Conflicts
  conflicts list/resolve/dismiss

Editing
  update-episode/update-concept
  delete-episode/restore-episode/purge-episode
  delete-concept/restore-concept/purge-concept

Embeddings
  embed-episodes  Backfill embeddings
  re-embed        Recompute embeddings (--episodes/--concepts/--entities/--all)

Import / Export
  export/import

Skills
  skill-install  Install Remind skills

UI
  ui           Launch the web UI
Entity types: file, function, class, module, subject, person, project, tool — format is type:name (e.g., file:src/auth.ts, person:alice, tool:redis, concept:caching)
Documentation
Full documentation at sandst1.github.io/remind:
- What is Remind? — How it works
- Skills + CLI — Agent integration
- Configuration — Providers, config
- CLI Reference — All commands
- MCP Tools — MCP reference
License
Apache 2.0 (LICENSE)
Preguntas sobre Remind MCP
¿Requiere Remind una API key o configuración?
No. Remind utiliza embeddings locales a través de fastembed por defecto, por lo que funciona sin configuración ni API key.
¿Qué herramientas MCP expone Remind?
El MCP server expone las herramientas remember, recall, snapshot y apply, además de la gestión de conflictos y entidades.
¿Dónde almacena Remind la memoria por defecto?
La memoria local se almacena como registros JSON deterministas en .remind/memory/, los cuales pueden incluirse en el código; también es compatible con URLs de SQLite, PostgreSQL y MySQL.
¿Puedo usar embeddings de OpenAI en lugar de los locales?
Sí. Instala el extra de openai y establece embedding_provider a openai con tu API key.
¿Cómo aprenden los agentes a usar Remind?
Instala los agent skills incluidos (capture, context, curate) con remind skill-install para agentes como Claude, Cursor, Codex u OpenCode.